„Ethik mit gebührendem Abstand“: Kate Crawford Buchauszug
Foto (detail): Benjamin Gremler / Unsplash
In ihrem neuen Buch Atlas of AI beschäftigt sich die führende Expertin Kate Crawford mit der Frage, inwieweit die auf künstliche Intelligenz (KI) gestützten globalen Netzwerke der Umwelt schaden, die Ungleichheit festigen und eine Verschiebung hin zu undemokratischen Regierungsformen fördern.
Ob es nun Online-Übersetzungstools sind, die bestimmten Berufen willkürlich ein Geschlecht zuordnen, oder Gesichtserkennungssoftware, die schwarze Gesichter nicht richtig erkennt: Es gibt zahlreiche Beispiele für von künstlicher Intelligenz (KI) erzeugte Voreingenommenheit.
Die meisten KI-Systeme weisen Eigenschaften der dominanten Stimme in ihrem Programmcode und in den Trainingsdaten auf – und diese Stimme ist die eines männlichen Weißen. Aber diese Voreingenommenheit ist nicht über Nacht auf getaucht, sondern sie ist das Resultat jahrzehntelanger Entwicklungen in diesem Bereich. Nach Ansicht der australischen KI-Expertin Kate Crawford haben die Forscher im Lauf der Zeit die Beziehung zum Gegenstand ihrer Untersuchungen verloren. In jüngster Zeit lassen sich Kreative in ihrer Kunst von diesem Prozess inspirieren, wie die Beispiele von Caroline Sinders und Joy Buolamwini zeigen.
In ihrem neuen Buch Atlas of AI untersucht Crawford das rasante Wachstum der KI in einer Umgebung, in der „ethische Fragen von den technischen getrennt werden“. Der folgende Auszug aus ihrem Buch trägt den Titel „Ethik mit gebührendem Abstand“.
In der Frühzeit der KI galt Forschung, für die Information über Menschen verwendet wurde, normalerweise als wenig riskant. Obwohl die für das Maschinenlernen verwendeten Daten oft von Menschen stammen und ein Bild von diesen Menschen und ihrem Leben zeichnen, wurde die Forschung, die sich dieser Datensätze bediente, eher als ein Form von angewandter Mathematik betrachtet, die kaum Auswirkungen auf menschliche Subjekte hatte. Die Infrastrukturen für die Aufrechterhaltung ethischer Standards, darunter die Ethikkommissionen von Universitäten, akzeptierten diese Position seit langem. Anfangs war das durchaus nachvollziehbar, denn die Ethikkommissionen konzentrierten sich im Wesentlichen auf die in biomedizinischen und psychologischen Experimenten angewandten Methoden, die offenkundige Risiken für einzelne Personen bargen. Die Computerwissenschaft hingegen galt als sehr viel abstrakter.
Als die KI in den achtziger und neunziger Jahren die Forschungslabore verließ und in der realen Welt Fuß fasste – und beispielsweise eingesetzt wurde, um Prognosen dazu anzustellen, welche Straftäter wahrscheinlich rückfällig werden dürften oder welche Personen Sozialhilfe erhalten sollten –, stieg ihr Potenzial, Schaden anzurichten. Obendrein waren nicht nur einzelne Personen, sondern ganze Gemeinschaften von schädlichen Auswirkungen bedroht. Trotzdem ist weiterhin die Annahme verbreitet, öffentlich zugängliche Datensätze stellten ein geringes Risiko dar und sollten daher von der ethischen Prüfung ausgenommen werden. Diese Vorstellung ist das Produkt einer früheren Ära, in der es schwieriger war, Daten von einem Ort zum anderen zu bewegen, und in der die Kosten für die langfristige Speicherung der Daten sehr hoch waren. Diese früheren Annahmen sind der gegenwärtigen Realität des Maschinenlernens nicht mehr angemessen: Heute können Datensätze leichter miteinander verknüpft werden, sie können einer beliebigen Zahl von Zwecken angepasst und laufend aktualisiert werden, und sie werden oft außerhalb des Kontextes verwendet, in dem sie ursprünglich gesammelt wurden.
Sobald KI das Labor verlässt und in die reale Welt eintritt, erweitern sich die potenziellen Schäden
|Foto: Jürgen Jester / UnsplashDas Risikoprofil der KI ändert sich rasch, da ihre Werkzeuge invasiver werden und die Forscher immer häufiger auf Daten zugreifen können, ohne mit ihren Subjekten interagieren zu müssen. Beispielsweise veröffentlichte eine Gruppe von Forschern auf dem Gebiet des Maschinenlernens eine Arbeit, in der sie behaupteten, ein „automatisches System zur Klassifizierung von Straftaten“ entwickelt zu haben. Die Forscher konzentrierten sich darauf zu identifizieren, ob ein Gewaltverbrechen mit Bandenkriminalität zusammenhing, und erklärten, ihr neuronales Netz könne dies anhand von nur vier Informationselementen bestimmen: Art der Waffe, Zahl der Verdächtigen, Art der Nachbarschaft und Tatort. Sie stützten sich auf einen Datensatz der Polizei von Los Angeles, der tausende Verbrechen enthielt, die nach Einschätzung der Polizei in Zusammenhang mit der Bandenkriminalität standen.
Obwohl bekannt ist, dass solche Daten tendenziös sind und zahlreiche Fehler enthalten, verwenden Forscher diese und ähnliche Datenbanken als Quelle für das Training von KI-gestützten Prognosesystemen. Beispielsweise hat sich herausgestellt, dass die CalGang-Datenbank, die von der Polizei in Kalifornien umfassend genutzt wird, erhebliche Ungenauigkeiten aufweist. Bei einer Prüfung durch den Bundesstaat stellte sich heraus, dass die Daten in 23 Prozent von hunderten geprüften Akten nicht zuverlässig genug waren, um sie in die Datenbank aufzunehmen. Die Datenbank enthielt auch Daten zu 42 Minderjährigen, von denen 28 aufgenommen worden waren, weil sie „erklärt hatten, einer Bande anzugehören“. Die meisten Erwachsenen in der Liste waren nie angeklagt worden, aber nachdem ihre Nahmen einmal ihren Weg in die Datenbank gefunden hatten, gab es keine Möglichkeit mehr, sie wieder zu löschen. Einige Personen waren aus vollkommen irrelevanten Gründen in die Datenbank geraten, zum Beispiel, weil sie beim Gespräch mit einem Nachbarn ein rotes Hemd getragen hatten. Mit derart nichtigen Begründungen wurden unverhältnismäßig viele Schwarze und Personen lateinamerikanischer Herkunft in die Liste aufgenommen.
Die CalGang-Datenbank, die von der Polizei in Kalifornien häufig verwendet wird, weist nachweislich große Ungenauigkeiten auf
|Foto: Sean Lee / UnsplashAls die Forscher ihr Prognoseprojekt zur Bandenkriminalität bei einer Konferenz vorstellten, reagierten einige Teilnehmer besorgt. Wie die Zeitschrift Science berichtete, waren unter den Fragen aus dem Publikum folgende: „Wie konnte das Team überhaupt sicher sein, dass die Trainingsdaten nicht voreingenommen waren?” Und: „Was geschieht, wenn jemand fälschlich als Bandenmitglied eingestuft wird?” Hau Chan, ein mittlerweile an der Universität Harvard tätiger Informatiker, der die Arbeit vorstellte, antwortete, er könne nicht wissen, wie das neue Werkzeug verwendet würde. „Derartige ethische Fragen kann ich nicht angemessen beantworten“ erklärte er, denn schließlich sei er „nur ein Forscher“. Ein Zuhörer beantwortete diese Aussage mit einem Zitat aus Tom Lehrers satirischem Song über den Raketenforscher Wernher von Braun: „Wenn die Raketen einmal in der Luft sind, wen kümmert es, wo sie runterkommen?”
Diese Abkoppelung der ethischen von den technischen Fragen ist Teil eines übergeordneten Problems dieses Forschungsgebiets: Die Verantwortung für schädliche Auswirkungen wird entweder nicht anerkannt oder es wird davon ausgegangen, dass sie außerhalb des Geltungsbereichs der Forschung liegt. Wie Anna Lauren Hoffman schreibt: „Das Problem sind hier nicht nur voreingenommene Datensätze oder unfaire Algorithmen und unbeabsichtigte Konsequenzen. Ein hartnäckiges Problem ist, dass Forscher aktiv Ideen reproduzieren, die verwundbaren Gemeinden Schaden zufügen und bestehende Ungerechtigkeit vertiefen. Selbst wenn das vom Harvard-Team vorgeschlagene System zur Identifizierung von Bandenkriminalität nie eingeführt wird, muss man fragen, ob nicht bereits Schaden entstanden ist. War nicht das Projekt an sich ein Akt der kulturellen Gewalt?“ Die Ausklammerung ethischer Fragen ist an sich schädlich und trägt zur Verfestigung der falschen Vorstellung bei, die wissenschaftliche Forschung finde in einem Vakuum statt und sei nicht verantwortlich für die von ihr verbreiteten Ideen.
Der KI-Wissenschaftler Joseph Weizenbaum schrieb 1976, dass die Computerwissenschaft bereits versucht, alle menschlichen Kontexte zu umgehen
|Foto: Chris Barbalis / UnsplashDie Reproduktion schädlicher Ideen ist besonders gefährlich, weil die KI längst nicht mehr die experimentelle Disziplin ist, die nur in Laboren praktiziert wurde. Mittlerweile wird die KI an Millionen Menschen getestet. Technische Neuerungen können rasch von Konferenzpräsentationen auf Produktionssysteme übertragen werden, wo sich schädliche Annahmen festsetzen können und kaum noch rückgängig zu machen sind.
Maschinenlernen und Methoden der Datenwissenschaft können eine abstrakte Beziehung zwischen Forschern und Subjekten erzeugen, eine Beziehung, in der die Arbeit aus der Distanz gemacht wird, fernab der Gemeinden und Individuen, denen sie schaden könnte. Die KI-Forschung hat seit langem eine distanzierte Beziehung zu den Menschen, deren Leben Gegenstand der Datensätze ist. Als der KI-Forscher Joseph Weizenbaum im Jahr 1976 seine beißende Kritik an diesem Forschungsgebiet verfasste, beobachtete er, dass die Computerwissenschaft bereits versuche, alle menschlichen Kontexte zu umgehen. Er erklärte, Datensysteme erlaubten es den Wissenschaftlern in Kriegszeiten, psychologisch auf Distanz zu den Menschen zu gehen, „die von den Waffensystemen verstümmelt und getötet werden, die das Ergebnis ihrer Ideen sind“. Die Lösung für dieses Problem sah Weizenbaum darin, sich direkt mit dem auseinanderzusetzen, was die Daten tatsächlich repräsentierten: „Die Lehre ist, dass sich der Wissenschaftler und der Technologe durch Willensakte und Imagination aktiv bemühen müssen, diese psychologische Distanz zu verringern und den Kräften entgegenzuwirken, die ihn von den Konsequenzen seiner Handlungen isolieren. Er muss – es ist tatsächlich so einfach –, darüber nachdenken, was er eigentlich tut.“
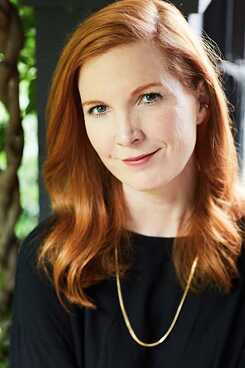
Kate Crawford
|Foto: Cath MuscatWeizenbaum hatte die Hoffnung, Wissenschaftler und Technologen würden sich eingehender mit den Auswirkungen ihrer Arbeit und damit auseinandersetzen, wem sie möglicherweise schaden konnte. Aber diese Nachdenklichkeit setzte sich auf dem Gebiet der KI nicht durch. Stattdessen werden die Daten zumeist als etwas betrachtet, dessen man sich bei Bedarf bedienen kann, um es ohne Einschränkungen zu verwenden und ohne Kontext zu interpretieren. Es ist eine gierige internationale Kultur der Datensammlung entstanden, die ausbeuterisch und invasiv sein und bleibenden Schaden anrichten kann. Und zahlreiche Branchen, Institutionen und Personen haben starke Anreize, an der kolonisierenden Einstellung festzuhalten, die Daten stünden zur freien Verfügung, und haben kein Interesse daran, dass die herrschende Praxis in Frage gestellt oder reguliert wird.
Dieser Auszug aus Atlas of AI wird hier mit freundlicher Genehmigung von Kate Crawford und der Yale University Press abgedruckt. Das Buch ist hier erhältlich.
Artikelvorschläge
Ein Systemfehler ist aufgetreten. Versuchen Sie es später noch mal.